站内信
概述
站内信
站内信得基本概念如下:
站内信是网站或应用内置的消息推送系统,主要服务于注册用户的内部通信需求,包含收件箱、发件箱、草稿箱和垃圾箱等基础模块。其通过数据库记录实现信息传递,支持用户间点对点消息传送及管理员向特定用户群体批量群发,与电子邮件系统存在技术差异。系统普遍配备状态追踪(已读/未读标识)、邮件提醒等功能,并通过权限分级限制使用范围。
该功能广泛应用于电商、教育、社交媒体等领域,技术实现包含Redis缓存+MQ消息队列架构、模板化设计与分库分表存储方案。部分平台通过分布式架构优化实时状态同步机制,并集成消息撤回、附件上传等扩展功能。典型应用场景包括研招考试通知、供应链协同管控等,平台通过消息中心组件可实现分页查看、批量标记已读等管理操作
需求
相较于完整站内信功能,我们实现的是一个阉割的版本,基于概念需要实现的功能有:
- 正常的消息推送
- 点对点通信和点对面通信
- 提醒功能
- 已读和未读功能
然后再此基础上还要追加的功能:
- 在线用户需要能即时接收到消息
- 消息有不同的类型,需要进行区分:
- 公告消息需要面向所有注册和未注册用户
- 支持,活动,消费等细则的点对点的消息需要进行用户隔离,保持一致性和可靠性
实现方法
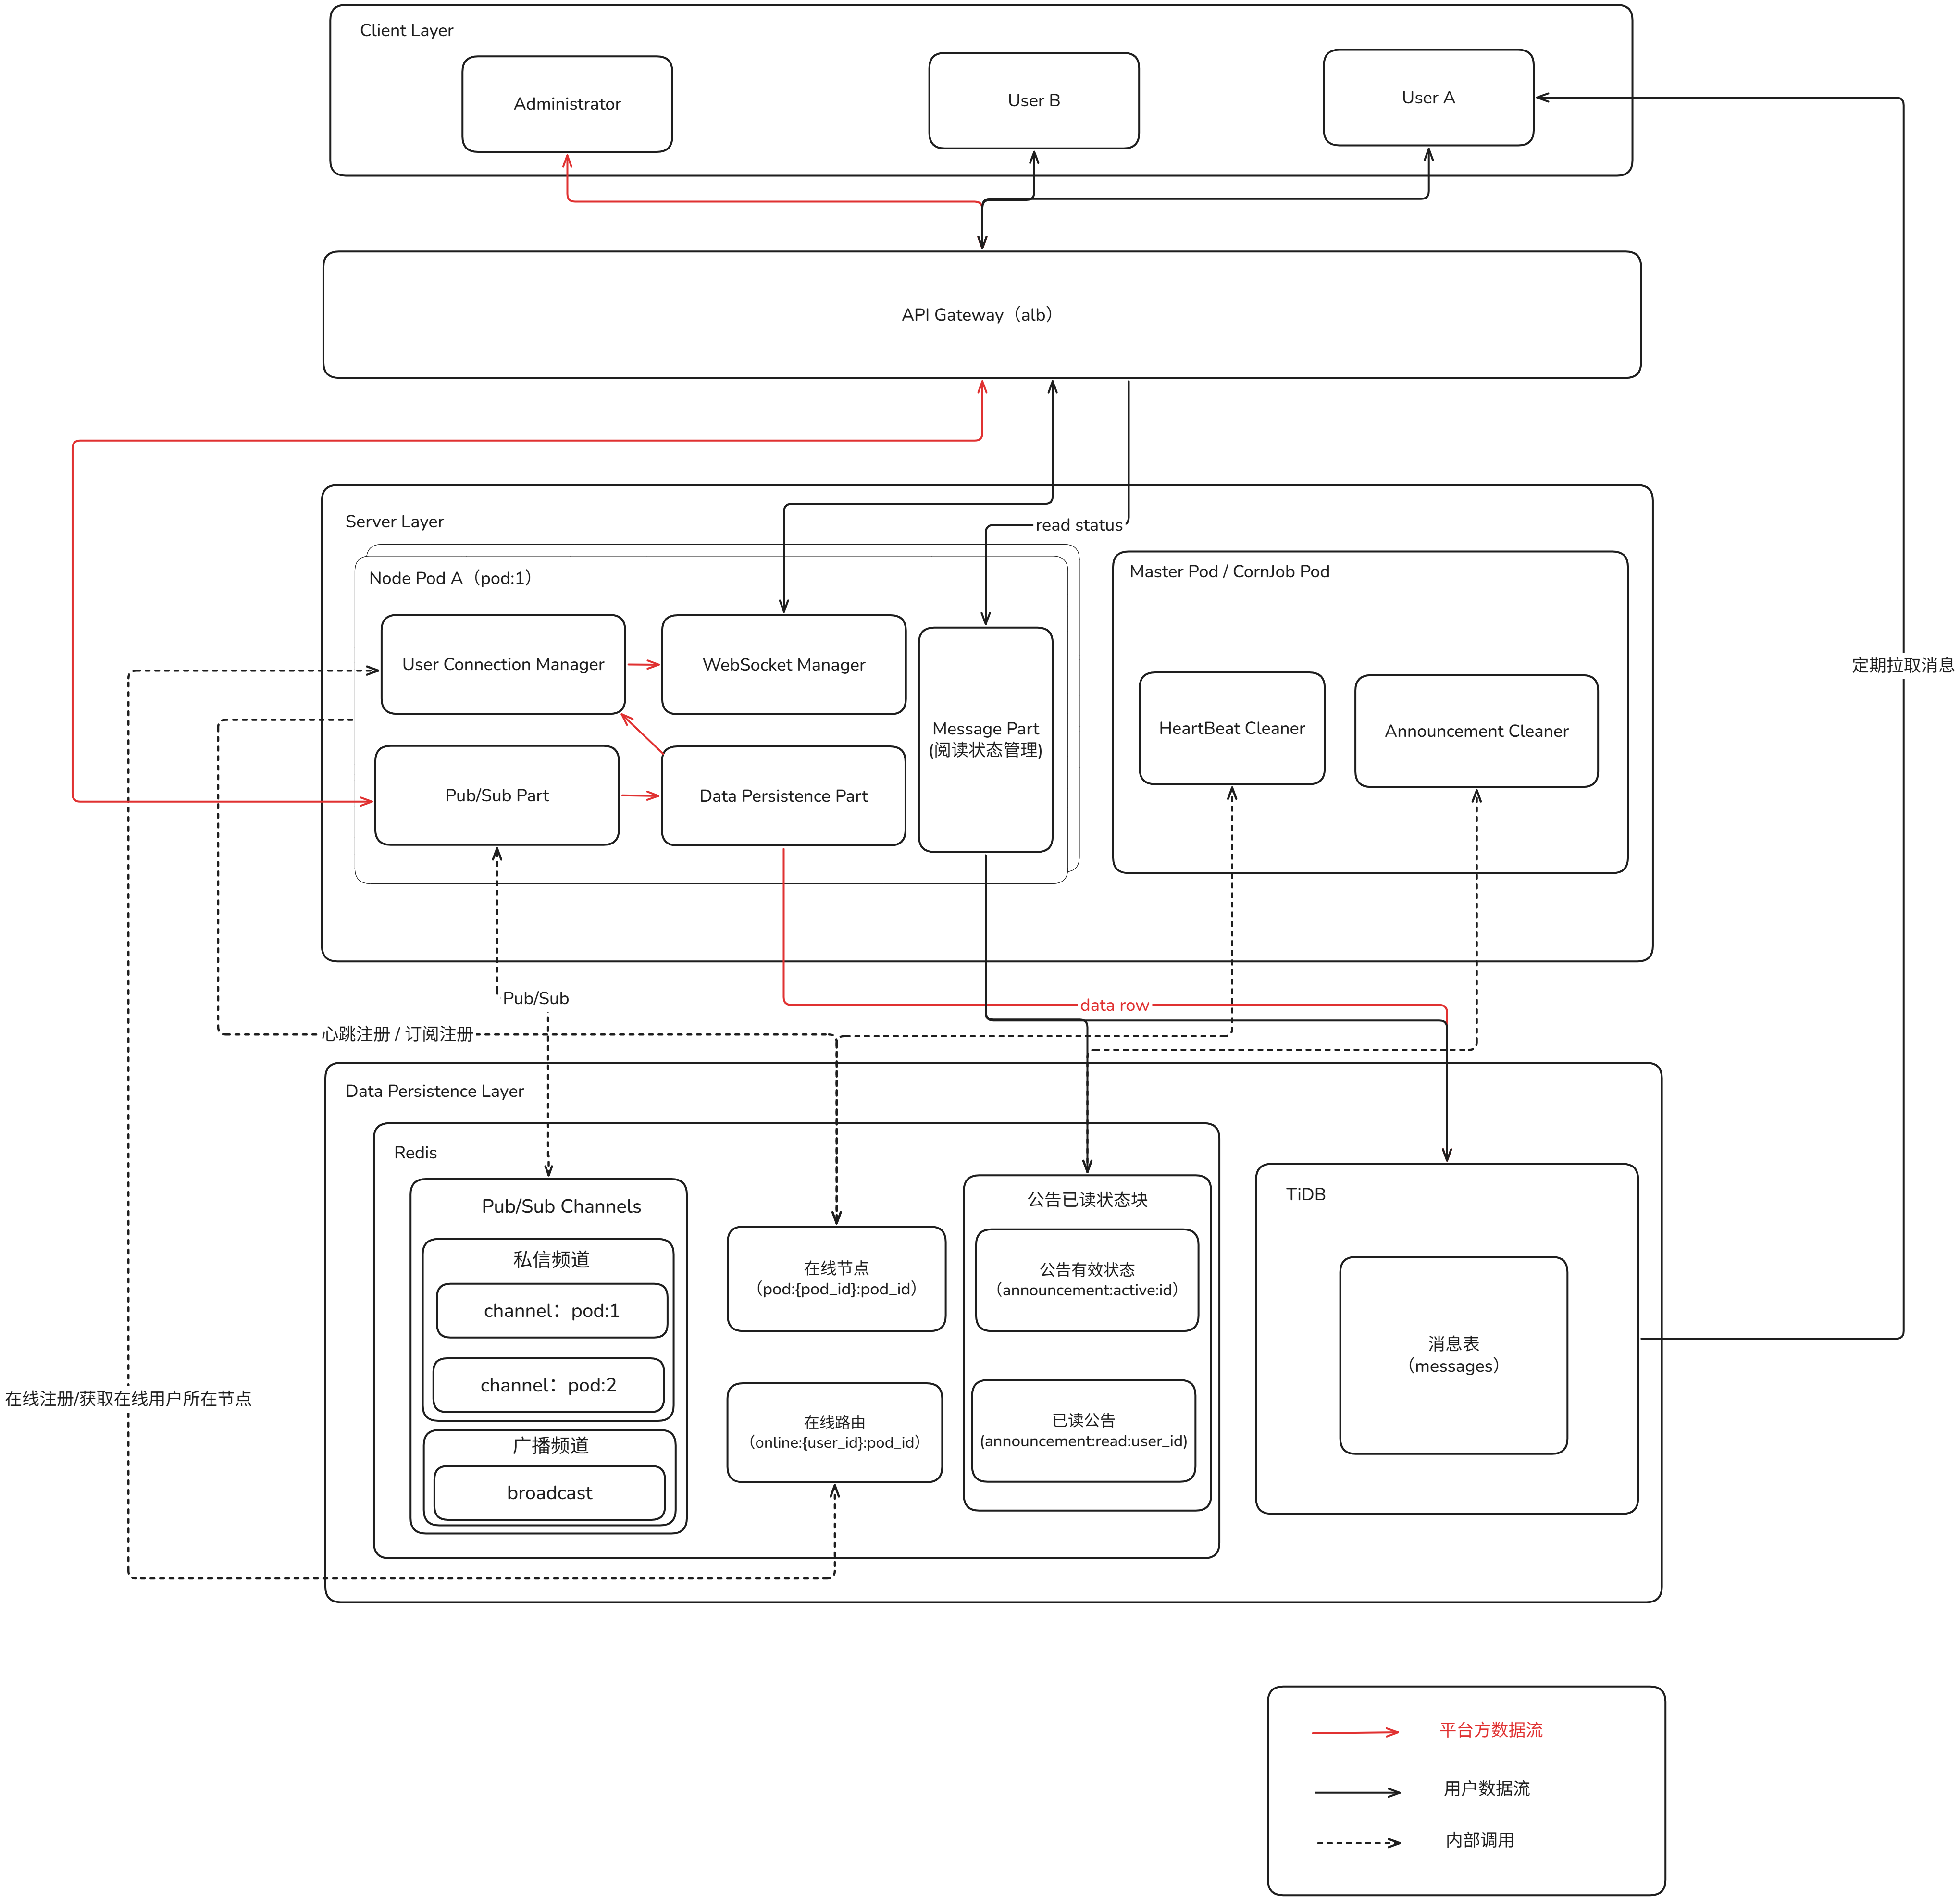
大概的系统架构如图,这是一个相对简单的分布式实现版本。
主要的技术栈有:
- TiDB(Mysql)兼容
- Redis
- WebSocket
具体功能为:
定时运维与资源兜底(CronJob),cornJob 节点启动定时任务抢占分布式锁,单实例定期清理:
- 僵尸 Pod 清理:扫描节点池,剔除超期未续约心跳的 Pod 及其残留路由。
- 过期公告清理:基于业务保留期限,从 Redis 活跃池清理已失效公告,释放内存。
节点自发现与连接生命周期:
- Pod 启动:在 Redis 注册自身 pod_id 并维持心跳;同时开启 Pub/Sub 协程,持续监听自身专属频道(channel:pod:{id})与全站广播频道(broadcast)。
- 用户上线:客户端经 ALB 建立 WebSocket 长连接,对应 Pod 在本地内存维护该连接,并在 Redis 登记在线路由(online:{user_id} -> {pod_id})。
- 用户断开:注销本地长连接句柄,并清理 Redis 中的用户在线路由映射。
消息写入与精准分发:
消息经 ALB 进入某个 Pod 后,首先落库持久化(DB 保存完整记录;若是公告,同步写入 Redis 活跃池 ZSet):- 公告消息:该 Pod 不仅在本地推送,更会向 Redis 的 broadcast 频道执行 PUBLISH,触发集群所有 Pod 并发向各自本地的在线连接进行扇出推送。
- 点对点私信:查询 Redis online:{target_uid} 路由:
- 目标在线:向其所在的专属频道(如 channel:pod:2)发布事件,仅由目标 Pod 消费并在本地 WebSocket 下发,避免集群广播风暴。
- 目标离线:流程终止,消息仅保留在 DB 中。
上线补偿与已读状态对齐:
- 上线增量拉取:离线或新连用户上线后,根据本地最后消息位点,使用游标分页向服务端发起单 SQL 合并拉取(私信 + 公告)。
- 轻量已读计算:用户阅读后,将公告 ID 写入 Redis 的用户专属已读集合({user:uid}:read);服务端利用 Pipeline 批量比对公告活跃池与已读集合,高效完成未读数计算。
数据表设计
赶工版
由于工期相对比较赶,并且要求数据表尽可能简洁,因此将两张表的数据压缩为一张表,并且要求要保存公告的阅读状态。
因此具体的思路就是在数据库中将公告视为点对点消息,将公告的阅读状态单独维护到 Redis 中。
1 | CREATE TABLE user_notification ( |
功能完整版本
单张表的问题:
由于公告的阅读状态是一个一对多的数据,因此每一条数据都需要单独保存,如果参考赶工版,要么直接将公告复制 N 份到数据表中,要么单独额外一个保存公告的数据结构。
如果存在一条大文本数据,那么每次 update 会非常耗时。将需要频繁更新的数据表独立出来,可以减少不需要的磁盘 IO
不方便定期归档,历史大文本和实时已读更新揉在一起,冷热分离和数据归档会极其痛苦,很难进行水平扩容。
这一块其实是读扩散和写扩散的问题。
1 | CREATE TABLE `message` ( |
1 | CREATE TABLE `message_user_state` ( |
容错处理
如果数据库挂掉,前端会定期拉去数据库数据,将未读消息直接读取出来,然后前端去重排序,得到结果。
分布式限流器
需求
该系统部署于 Kubernetes 集群中,作为网关请求链路上的基础中间件,为 API 请求提供多维度、多层级的限流能力。在保证限流准确性的同时,需要兼顾热路径低延迟、集群动态扩缩容以及 Redis 故障下的可用性。
- 多维度限流:
- 特殊 API Key
- 用户
- 用户等级
- 模型系列
- 多种限流方式:
- 支持基于 RPM 的请求频率限流
- 分布式限流
- 中心化限流
- 企业定制化限流
- 基于 Token 的用量限流。
- 支持基于 RPM 的请求频率限流
- 低延迟要求:由于限流系统处于请求热路径,需要尽可能减少网络访问和锁竞争,通过本地令牌桶优先完成快速判定,仅在必要场景访问 Redis。
- Redis 故障降级:当 Redis 不可用或访问超时时,系统需要自动进入降级模式,同时通过告警及时发现异常。
- Kubernetes 动态扩缩容:根据 K8s Pod 的动态扩缩容情况自动感知在线实例数量,并动态调整各 Pod 的本地限流配额,使集群总限额保持在合理范围内,避免扩缩容造成限流突刺。
- 集群一致性:通过 Pod 心跳、Redis 中心状态及配置广播保证限流配置能够在集群内快速同步。考虑到本地限流的性能要求,允许不同 Pod 之间存在一定范围的配额误差,在性能与精确一致性之间进行平衡。
- 配置热更新:支持 RPM、Token 配额、模型规则、用户等级及封禁名单等配置动态修改,通过 Redis Pub/Sub 向集群广播,使配置无需重启服务即可生效。
实现方法
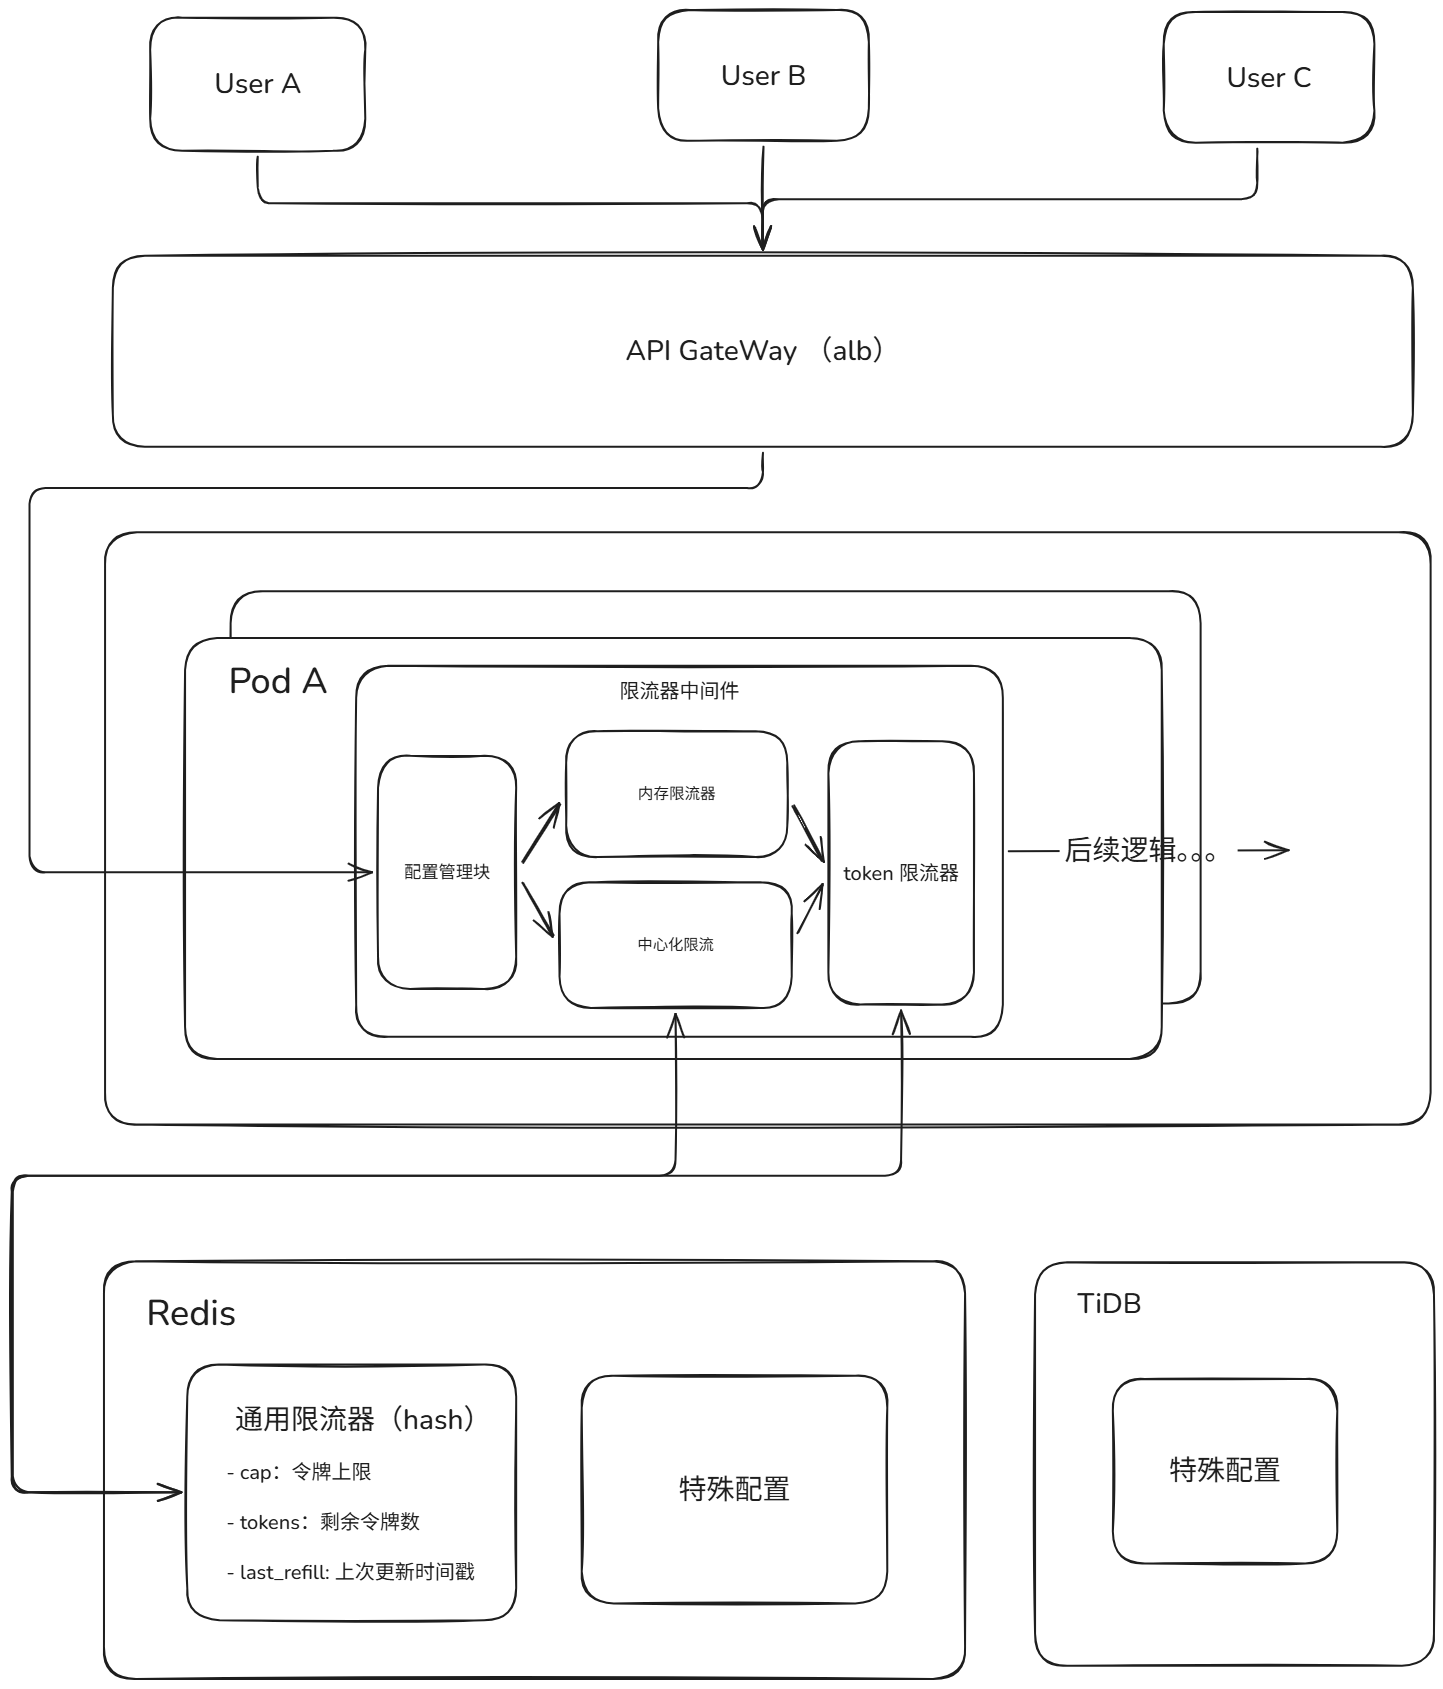
定时清除(CronJob):每个 hash bucket 都有一定过期时间,大概为桶满时间*1.5 倍,过期会定期清除这部分 Key
扣减链路:请求经 ALB 均衡到达某个 Pod 后,提取具体上下文(API Key、用户等级、模型系列),下文中的 N 为节点数量。
- RPM 限流器
- 如果($\text{Quota}{\text{local}} = \lceil\frac{\text{Quota}{\text{total}}}{N}\rceil >= 1$),直接在 Pod 内存的 Local Token Bucket 中扣减。
- 如果用户为风险用户,或者为限制性用户,那么就会选择中心化限流
- token 限流器
- 计算当前可用 token,如果超过限额,直接拒绝请求
- 后续逻辑。
- RPM 限流器
本地令牌桶将判定耗时压降至 0.1 ms(P99)以内,就地过滤绝大部分突发峰值流量;中心化 Lua 限流控制在 25 ms (P99)内。
注意事项
微令牌与残差对齐
计算令牌恢复的公式为:
$token_{refill} = \frac{(now - last_refill)*10^6}{60} * RecoveryRate$
lua 脚本中需要计算部分都进行了放大处理,防止出现极小数字导致信息丢失的情况。比如一个常见的情况,一个用户大量访问,每次 now - last_refill = 1,计算机获取极小数导致精度丢失。
多模态素材管理中台
需求分析
该系统面向多供应商 AI 素材管理场景,主要解决不同供应商接口协议不统一、异步任务处理复杂、重复扣费以及数据同步可靠性等问题。
- 统一素材管理:对外提供统一的兼容接口,通过防腐层完成请求与响应转换,屏蔽不同供应商的接口差异。
- 多供应商接入:通过适配器和注册机制接入供应商,新增供应商无需修改对外 API。
- 异步任务处理:采用“先占位、后轮询”模式,创建请求快速返回 task_id,后台异步轮询供应商并更新任务状态。
- 任务与扣费幂等:通过 external_task_id、数据库唯一键和 CAS 机制保证任务创建及扣费过程幂等,避免重复任务和重复扣费。
- 故障恢复:针对成功未扣费和中间态任务卡死等异常进行分类恢复,并通过内存去重与数据库租约避免多实例重复恢复。
- 事件驱动:对任务状态变化、素材更新、异常恢复等关键操作发布事件,为 Webhook、告警及后续业务扩展提供统一事件通道。
- 官方素材同步:通过定时任务按 updated_at 和数据哈希进行增量同步,并结合互斥锁、失败跳过删除、异常自愈和告警机制保证数据一致性。
实现方法
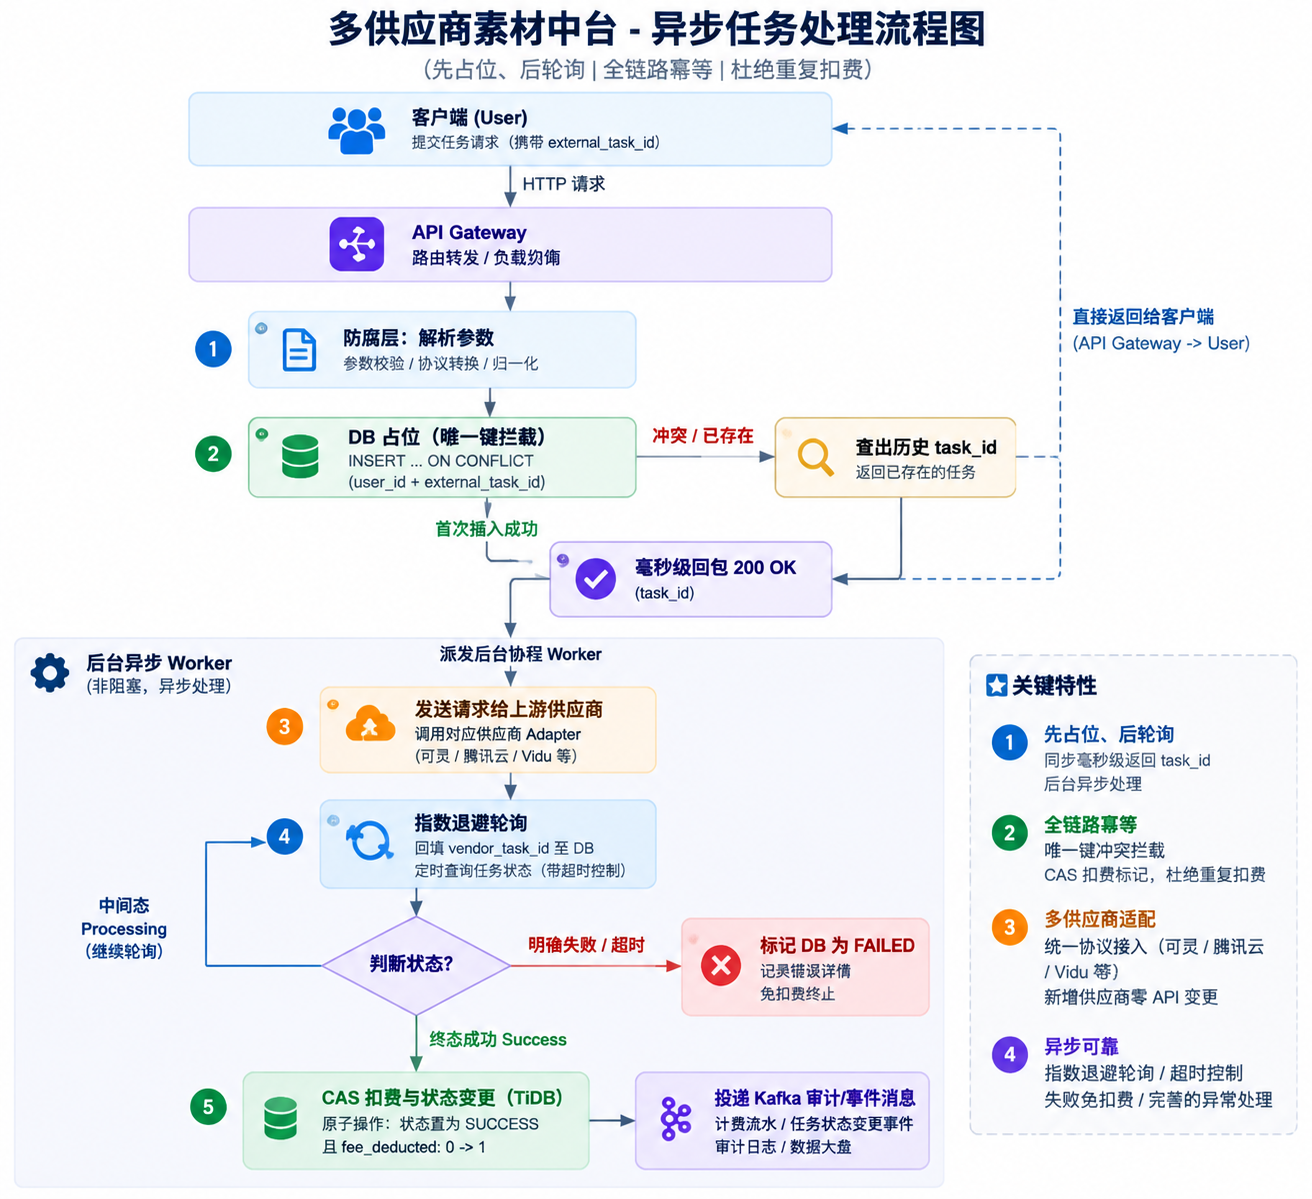
当不同供应商的请求发送过来之后,会依据用户标识与外部任务 ID 复合键,在数据库中创建一条初始占位记录(状态置为 PENDING)用来防止并发重复创建任务;若触发唯一键冲突,则直接读取存量任务 ID 原样返回,实现秒级前置防重与幂等拦截。
然后解析用户的参数,将指定格式的平台标准参数构建为供应商指定的专有参数格式与签名鉴权信息,然后发送请求:
同步任务:如果创建任务为同步任务,那么在供应商实时回包后,就会直接转化为平台指定格式返回给用户;若回包中包含图片或其他媒体资源,系统会异步或同步转存到指定对象存储(如 OSS/S3)中做持久化并生成 CDN 地址,再落库并响应。
异步任务:
快路径在完成数据库占位后,立即向客户端同步返回包含 task_id 的 200 响应,断开前端长连接;同时派发后台独立协程(Worker)非阻塞地向供应商发起创建请求,并将上游生成的 vendor_task_id 回填至数据库,状态流转为 PROCESSING。
指数退避轮询:后台协程携带最大超时与重试控制,以指数退避的方式定时轮询上游查询接口;上游一旦返回最终成功结果,便执行与同步任务相同的转存操作,将资源存入对象存储,更新素材库。
失败与断路:若轮询期间上游返回明确业务失败(如审核拒绝、参数违规)或触发最大超时,立即终止轮询并将状态标记为 FAILED,免扣费安全退出,避免死循环与协程泄漏。
Pod 崩溃与 Fallback 兜底:若出现执行过程中 Pod 整个挂掉(如 OOM 或发布重启),内存中的轮询协程丢失,系统会进入注册表驱动的 fallback 兜底恢复模式:
- 周期性定时任务扫描数据库中长时间处于中间态(PENDING / PROCESSING)卡死的任务;
- 结合内存 Inflight 去重与数据库租约锁(Lease)防止多实例重复拉起;
- 抢到锁的实例从数据库找到对应创建日志并重新拉起协程重试查询,直到任务流转至终态。
当在供应商内部成功创建出对应资源且状态确认为终态 SUCCESS,系统就会进入到扣费逻辑:
先在 TiDB 中通过 CAS 乐观锁条件更新(WHERE status = ‘PROCESSING’ AND fee_deducted = 0)将扣费标记由 0 置为 1,确保即使发生并发重试也绝对不会重复扣费;
数据库 CAS 扣费标记修改成功后,再将所有和扣费、任务终态相关的计费流水与审计信息放入 Kafka 消息队列中,由下游消费服务异步刷新落库到 TiDB 的查询日志和流水表中,供财务对账与数据大盘使用。
数据表设计
素材表根据供应商格式进行设计。
异步任务表
1 | CREATE TABLE `asset_tasks` ( |